
Das Backend ist produktiv relevant.
Ausfälle, lange Antwortzeiten oder fehlerhafte Verarbeitung wirken sich direkt auf Kunden, Umsatz oder interne Abläufe aus.

Backend-Entwicklung
Peak-Traffic ist kein Zufall. Er kommt, zum Kampagnenstart, zum Saisonpeak, zum Ausfall des Wettbewerbers. Ich baue Backends für SaaS-Produkte und Plattformen, die diesen Moment überstehen: in Go und PHP 8, event-getrieben auf AWS, mit Mandantentrennung und Wiederanlauf im Entwurf statt im Nachtrag.
Typischer Umfang 3–9 Monate, Teil- oder Vollzeit. Ein Architektur- oder Lastreview geht auch als abgeschlossenes Zwei-Wochen-Mandat.
Remote aus Deutschland. Direkt mit mir, ohne Agentur dazwischen.
Die Ausgangslage
Die meisten Backends sind nicht falsch gebaut, sondern für eine andere Größenordnung gebaut. Was mit zehntausend Nutzern funktioniert kippt bei einer Million an Stellen die vorher niemand auf dem Schirm hatte: ein Datenbank-Lock, ein synchroner Aufruf in einer Schleife, ein Connection Pool der zu klein dimensioniert ist.
Dazu kommt der zweite Effekt: Systeme unter Last fallen nicht als Ganzes aus, sie werden langsam. Timeouts stapeln sich, Retries verstärken die Last, aus einem Engpass wird ein Totalausfall. Dagegen hilft kein größerer Server, sondern ein Entwurf der Rückstau aushält.
Typische SymptomeFür wen das passt
Das Angebot richtet sich an CTOs, technische Leiter und Produktverantwortliche mit einem laufenden digitalen Produkt. Last, Zuverlässigkeit oder technische Altlasten begrenzen die nächste Wachstumsstufe – gesucht wird Architektur plus Umsetzung.
Ausfälle, lange Antwortzeiten oder fehlerhafte Verarbeitung wirken sich direkt auf Kunden, Umsatz oder interne Abläufe aus.
Datenmodell, Schnittstellen, Parallelität oder Betrieb sind wichtiger als eine weitere sichtbare Funktion.
Sie suchen keinen Architekturbericht für die Schublade, sondern jemanden, der Entscheidungen im Code und in Produktion mit umsetzt.
Was ich mache
Bevor Code entsteht klären wir, was das System aushalten muss: Requests pro Sekunde, Verhältnis von Peak zu Durchschnitt, Latenzbudget pro Aufruf. Danach messe ich, wo es heute bricht, mit Profiling und Lasttest, nicht mit Vermutungen.
Was nicht synchron sein muss wird asynchron: Queues, Events, idempotente Verarbeitung, Dead-Letter-Queues für den Fall der Fälle. Der Schnitt folgt fachlichen Grenzen und nicht Teamgrenzen. Er entscheidet später über die Betriebskosten.
Wo Durchsatz und Latenz zählen ist Go die pragmatische Wahl: kleiner Speicher-Footprint, echte Nebenläufigkeit, schnelle Starts. Bestehendes in PHP bleibt dabei wo es hingehört und wird sauber angebunden, statt alles auf einmal anzufassen.
Mehrere Kunden auf einer Infrastruktur, ohne dass ein großer Mandant die Antwortzeiten der anderen bestimmt: Isolation auf Daten- und Lastebene, Indizes und Query-Pfade die mitwachsen, Caching als bewusste Entscheidung statt als Abkürzung.
Jeder Aufruf bekommt ein Zeitbudget, jede Abhängigkeit einen Circuit Breaker, jede Last eine Grenze ab der kontrolliert abgewiesen wird. Multi-AZ als Standard, Wiederanlauf und Restore einmal mit gestoppter Uhr geprobt, damit im Ernstfall niemand raten muss.
Die API wird vor der Implementierung spezifiziert. OpenAPI für REST, Protobuf für gRPC, damit Integrationen ohne Rückfragen gelingen. Dazu CI/CD mit Tests, Blue/Green-Deployments, Feature Flags für riskante Änderungen und ein Rollback der geübt ist. Ein Release soll ein Nicht-Ereignis sein.
Einzelfälle
Ihr Backend soll den nächsten Peak überstehen?
Lassen Sie uns in 30 Minuten über Ihr Lastprofil sprechen.
Ablauf
Kein Wasserfall. Jeder Abschnitt endet mit etwas das Sie in der Hand halten: einer Zahl, einer Umgebung oder einem Release.
Was soll das System aushalten, wer betreibt es, was ist gesetzt. 30 Minuten reichen für die Einschätzung ob es passt.
Lastprofil, Engpassmessung, Zielarchitektur mit Service-Schnitt. Ergebnis ist ein Plan mit Reihenfolge und Aufwand.
Geliefert wird in Schritten die einzeln in Produktion gehen können. Tests, Pipeline und Terraform entstehen mit, nicht danach.
Lasttest gegen die vereinbarten Zahlen, Wiederanlauf geprobt, Runbooks, Pairing bis der Betrieb ohne mich sitzt.
Das Ergebnis
Sie wissen was Ihr System aushält, wo die nächste Grenze liegt und was es kostet sie zu verschieben.
Ein überlasteter Teil zieht den Rest nicht mit. Rückstau wird abgefangen statt weitergereicht.
Dokumentierte Entscheidungen, Runbooks und ein Team das weiterbauen kann. Kein Wissen das an einer Person hängt.
Eingesetzte Technologien
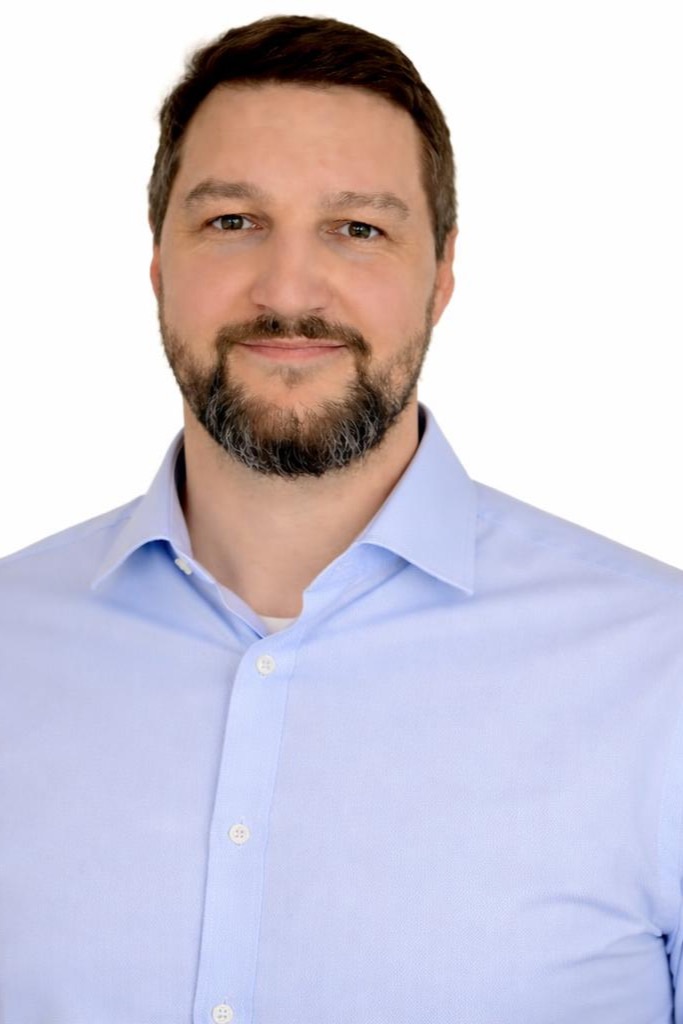
Mit wem Sie es zu tun haben
Ich bin Tim Rutte. Über 20 Jahre Softwareentwicklung, heute baue ich Backends, die unter Last halten und im Fehlerfall vorhersagbar bleiben. Sie sprechen mit der Person, die Ihren Code anfasst, vom ersten Gespräch bis zur Übergabe.
Zusammenarbeit
Sie müssen kein bestimmtes Setup mitbringen. Ich passe die Zusammenarbeit daran an, wie Ihr Unternehmen aufgestellt ist und wie viel Verantwortung Sie abgeben möchten.
Wenn Wissen und Verantwortlichkeiten bereits bei Ihnen liegen, steige ich dort ein, wo zusätzliche Erfahrung gebraucht wird. In Ihren Abläufen, mit direkter Abstimmung und ohne Parallelwelt.
Wenn intern Zeit oder Kapazität fehlt, übernehme ich ein klar abgegrenztes Vorhaben von der technischen Klärung bis zum produktiven Einsatz. Sie geben Ziel und Rahmen vor, ich kümmere mich um den Weg dorthin.
In beiden Modellen gilt: Sie sehen jederzeit, was entsteht, welche Entscheidungen anstehen und was als Nächstes passiert. Abgerechnet wird je nach Projektbedarf und Ihrem bevorzugten Modell: klar abgegrenzte Vorhaben zum Festpreis, längere und dynamische nach Aufwand.
Kontinuität
Auch bei eigenständiger Umsetzung entsteht keine Abhängigkeit von mir. Alles, was für Weiterentwicklung und Betrieb nötig ist, liegt vom ersten Tag in Ihrer Umgebung und wird laufend übergabefähig gehalten.
Code, Cloud-Accounts, Pipelines und Secrets liegen in Ihren Systemen. Der Betrieb hängt nicht an einem persönlichen Konto oder einem Zugang, den nur ich kontrolliere.
Architekturentscheidungen, Betriebsabläufe und bekannte Risiken werden dort dokumentiert, wo Ihr Team sie später findet – und während des Projekts aktuell gehalten.
Reproduzierbare Umgebungen, automatisierte Deployments und regelmäßige Übergaben sorgen dafür, dass Ihr Team oder ein anderer Dienstleister ohne Neustart weiterarbeiten kann.
Das Ziel ist nicht, dass Sie mich dauerhaft brauchen. Das Ziel ist, dass Sie jederzeit frei entscheiden können, wer das System weiterentwickelt.
Kundenstimmen
„Herr Rutte hat für uns ein komplett individuelles CRM entwickelt und dies genau auf unsere Bedürfnisse zugeschnitten. Die Zusammenarbeit war unkompliziert. Er hat unsere Anforderungen perfekt umgesetzt und das System läuft absolut stabil.“
„Tim hat bei uns als PHP-Entwickler gearbeitet und einen richtig guten Job gemacht. Er hat sich schnell ins Projekt eingearbeitet und auch bei kniffligen Themen immer eine Lösung gefunden. Der Code war sauber, nachvollziehbar und hat uns echt weitergebracht. Wir würden jederzeit wieder mit Tim zusammenarbeiten.“
„Die Entwicklung unserer Software wurde wie besprochen fertiggestellt und alle Probleme wurden beseitigt. Vielen Dank.“
Häufige Fragen
Nein. Ich baue Backend, Schnittstellen und Infrastruktur. Für Frontend und Design arbeite ich mit Ihrem Team oder den Dienstleistern zusammen, die Sie schon haben. Die Abstimmung läuft über den API-Contract, der vorher steht. Wenn Sie jemanden für das komplette Produkt inklusive Oberfläche suchen, bin ich der Falsche und sage das im Erstgespräch.
Nein. Ein gut geschnittener Monolith ist vielen verteilten Systemen überlegen und deutlich billiger im Betrieb. Ich zerlege nur dort wo es einen konkreten Grund gibt: unterschiedliche Lastprofile, unterschiedliche Release-Zyklen oder Teamgrenzen die sonst dauerhaft blockieren.
Oft nicht. Kubernetes ist ein gutes Werkzeug, wenn Sie mehrere Teams, viele Services und Menschen haben die den Cluster betreiben können. Für die meisten Setups ist ECS Fargate schneller am Ziel und günstiger im Betrieb. Ich entscheide das anhand Ihres Teams und Ihrer Last, nicht anhand des Trends.
Meistens bleibt die bestehende Sprache. Go setze ich gezielt dort ein wo Durchsatz, Latenz und Speicherverbrauch zählen, als zusätzlicher Service neben dem Bestand, angebunden über gRPC oder Queue. Wie das ohne Komplettumbau funktioniert, habe ich in einem eigenen Artikel beschrieben.
Ich schreibe Code. Der Entwurf entsteht am Anfang, aber der größte Teil der Zeit fließt in Implementierung, Tests und Pipeline. Beratung ohne Umsetzung führt in meiner Erfahrung zu Dokumenten die niemand liest.
Ja, und das ist der Regelfall. Ich arbeite im Pairing, dokumentiere Entscheidungen als ADR im Repository und übergebe bevor ich gehe. Das Ziel ist nicht Abhängigkeit von mir, sondern ein Team das selbst weiterbauen kann.
Begriffe, die hier vorkommen
Weitere Leistungen
Gewachsene Systeme schrittweise modernisieren: Strangler-Fig statt Rewrite, laufender Betrieb unangetastet, jeder Schritt umkehrbar.
Mehr erfahrenVom eigenen Rechenzentrum oder aus einer anderen Cloud nach AWS, mit Kostenmodell vor dem Umzug und Rollback-Pfad für jeden Schritt.
Mehr erfahrenIch finde wo Ihr AWS-Budget versickert, messbar reduziert, ohne Abstriche bei Performance oder Verfügbarkeit.
Mehr erfahrenDamit ein einzelner Fehler nicht die ganze Anwendung mitnimmt: Abhängigkeiten und Single Points of Failure gefunden, Wiederanlauf geprobt statt dokumentiert, Änderungen als Terraform.
Mehr erfahrenDie Infrastruktur hinter produktiven KI-Systemen: MCP-Server, sichere Tool-Anbindung, LLM-Integration mit Zugriffsschutz und Kostenkontrolle.
Mehr erfahrenManuelle Abläufe durch echte Systeme ersetzen: angebunden an Ihre Bestandssysteme, mit Berechtigungen und Protokoll statt Tool-Kette.
Mehr erfahren